
一次 AWS DNS 故障如何级联瘫痪半个互联网
本文转载自知乎, 原文地址 zhuanlan.zhihu.com
2025 年 10 月 20 日,AWS 最关键的 us-east-1 区域发生了一场持续 15 小时的重大故障,导致全球超过 1000 家企业服务中断。 而这场故障背后的根因,竟然仅仅是一条 AWS 内部 DNS 解析失效。
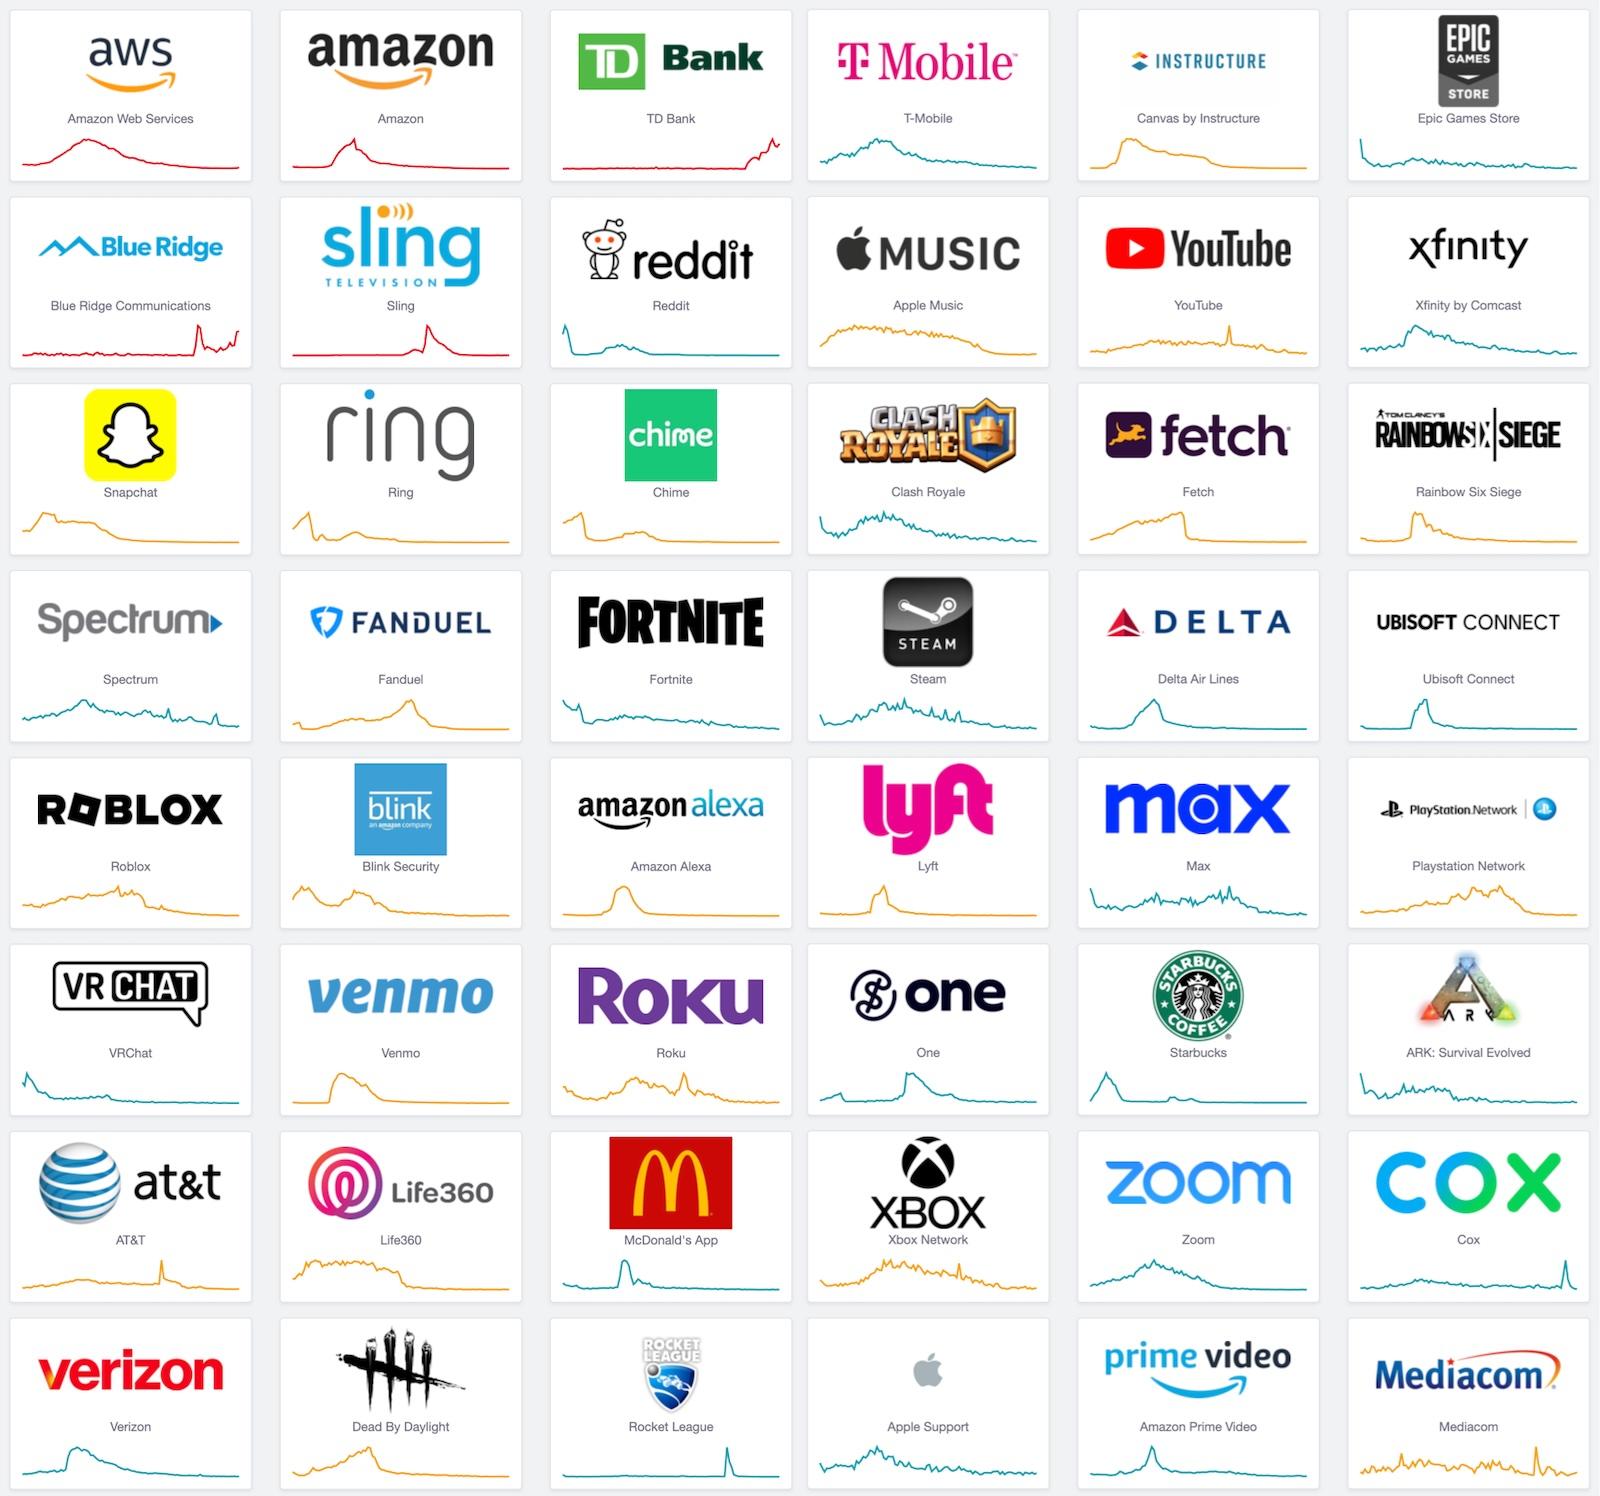
从凌晨的 DNS 解析失效开始,AWS DynamoDB、EC2、Lambda 等 142 项服务相继受到影响,进而导致全球互联网的大部分功能停转。 Snapchat、Roblox、Coinbase、Signal、Reddit、Robinhood 等热门应用离线,数十亿美元在半天内蒸发,这不啻于一场赛博世界的地震。
更令人警惕的是,因为 us-east-1 是所有 AWS 区域的公共控制平面所在地,即使工作负载部署在欧洲或亚洲的企业也未能幸免。 这场故障暴露了云计算时代最根本的脆弱性:一条损坏的 DNS 就能引发数十亿美元的经济损失。 这不是技术能力问题,而是架构哲学的失败 —— us-east-1 成了全球互联网依赖的中枢神经系统,而这个系统现在已经证明,它会定期失灵。
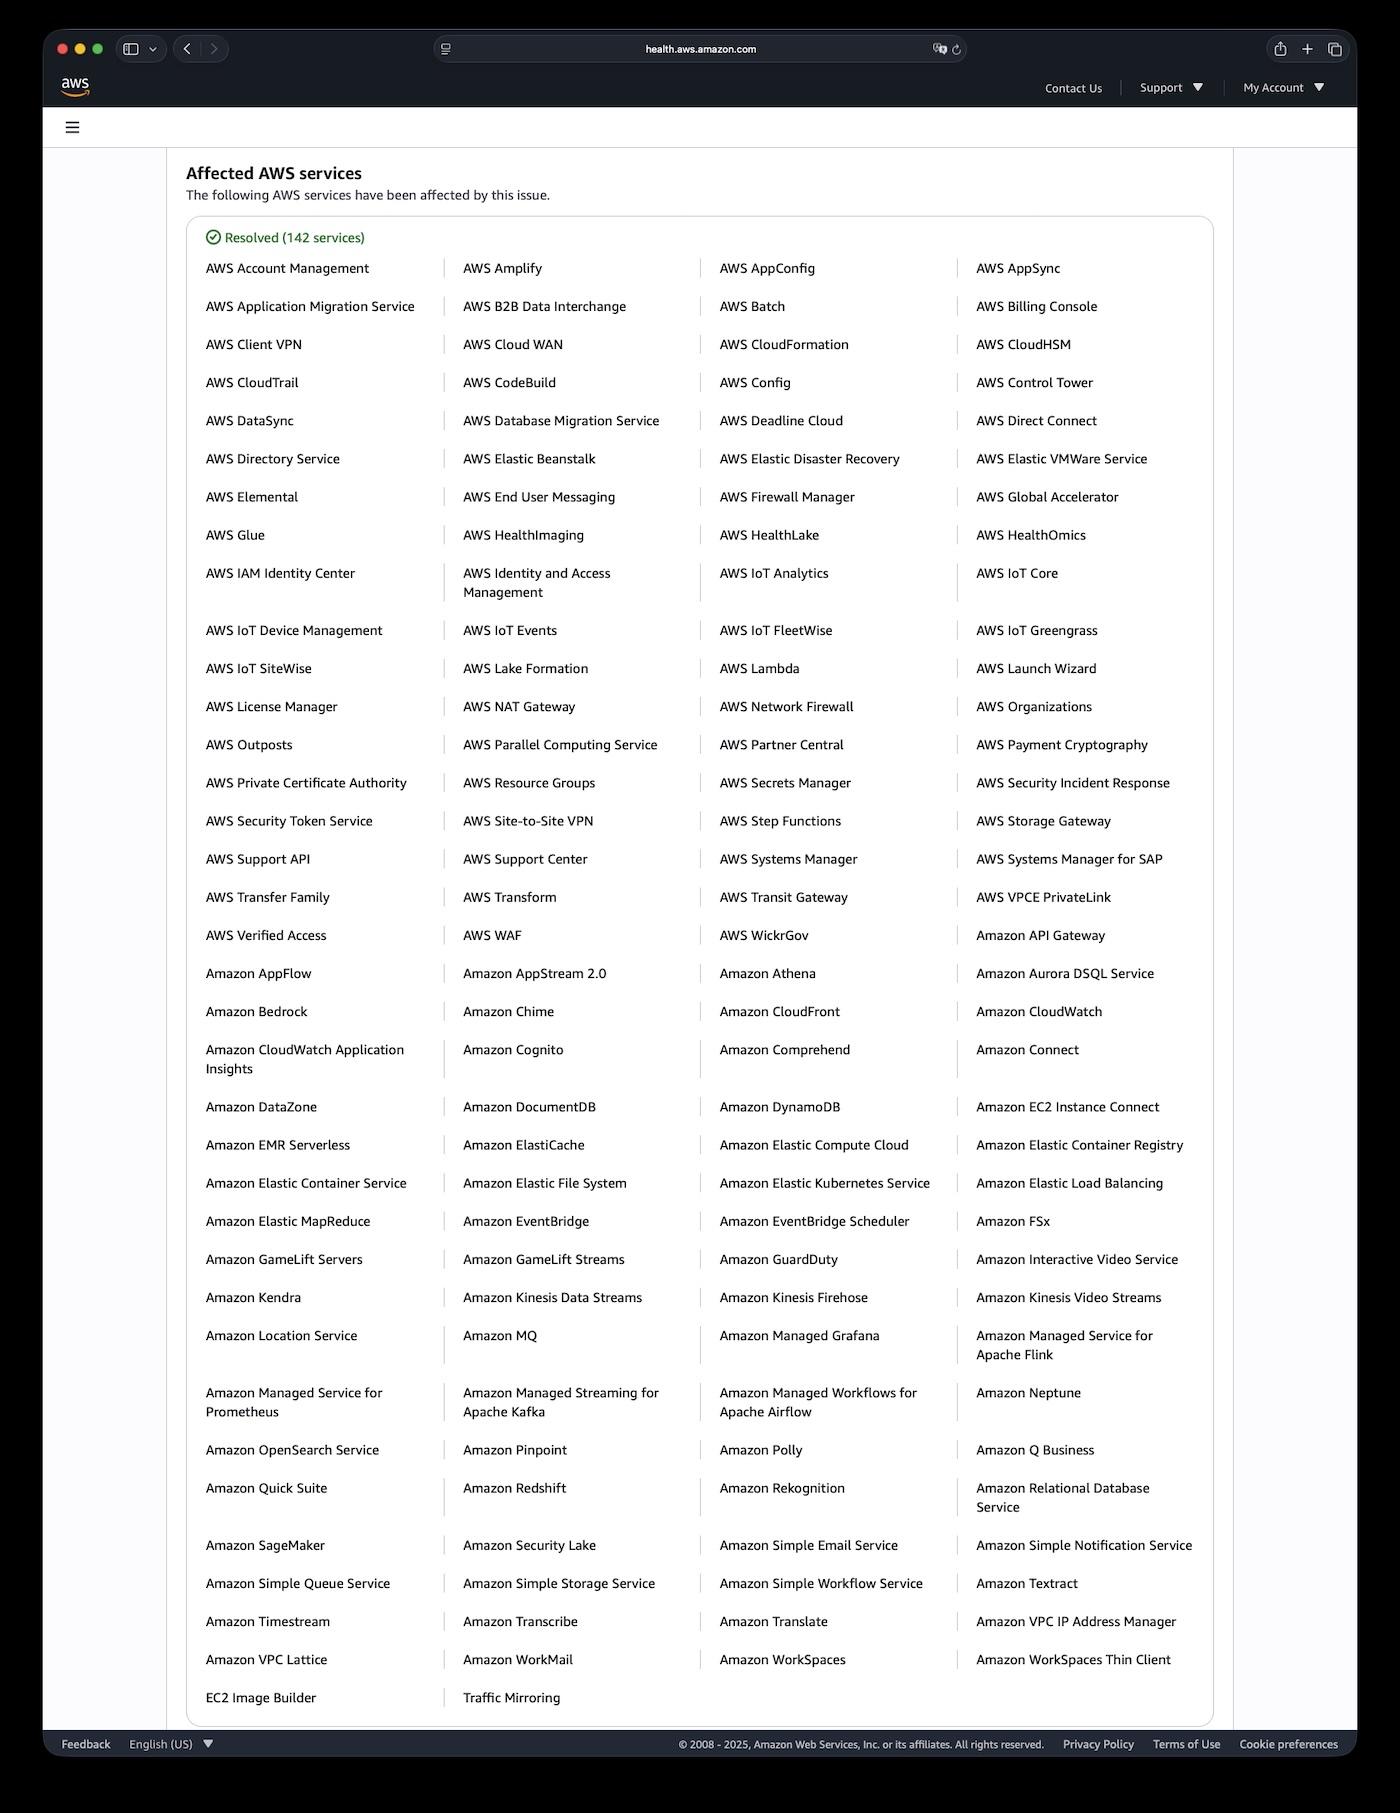
赛博地震:数十亿美元在半天内蒸发
这场持续 15 小时的故障,在全球数字经济中掀起了一场 “赛博地震”。Catchpoint CEO 预估经济损失达 “数十亿到数千亿美元”。
金融服务首当其冲。Robinhood 在美东交易时段完全离线,数百万散户投资者被锁在账户之外; Coinbase 的宕机让加密货币交易者在市场波动中束手无策; Venmo 收到 8000 份故障报告,用户的数字钱包瞬间 “消失”。在现代无现金社会,这相当于所有人同时失去了钱包。
游戏行业损失同样惨重。上亿日活的 Roblox 用户被迫下线,虚拟经济瞬间停摆; Epic Games 的 Fortnite、任天堂的 Pokémon GO、育碧的彩虹六号集体失声。 对这些依赖用户粘性的平台而言,每小时的宕机都可能意味着永久的用户流失。
英国的政府网站,税务,海关,银行系统受到影响,多家航空公司内部系统受损导致部分航班运营混乱。 更讽刺的是,Amazon 自家产品全线翻车 —— 购物网站、Alexa、Ring 门铃、Prime Video,甚至 AWS 自己的工单系统都未能幸免。 这充分说明:即使是 AWS 的创造者,也无法避免对 us-east-1 的单点依赖。
故障根因:DNS 失效引发的蝴蝶效应
太平洋夏令时 2025 年 10 月 19 日晚 11:49,us-east-1 区域的多个服务错误率突然攀升。 直到 22 分钟后,AWS 才在健康仪表板发布第一条确认。截止到 10 月 20 日下午 3:53 分结束,整个故障持续了近 16 小时。
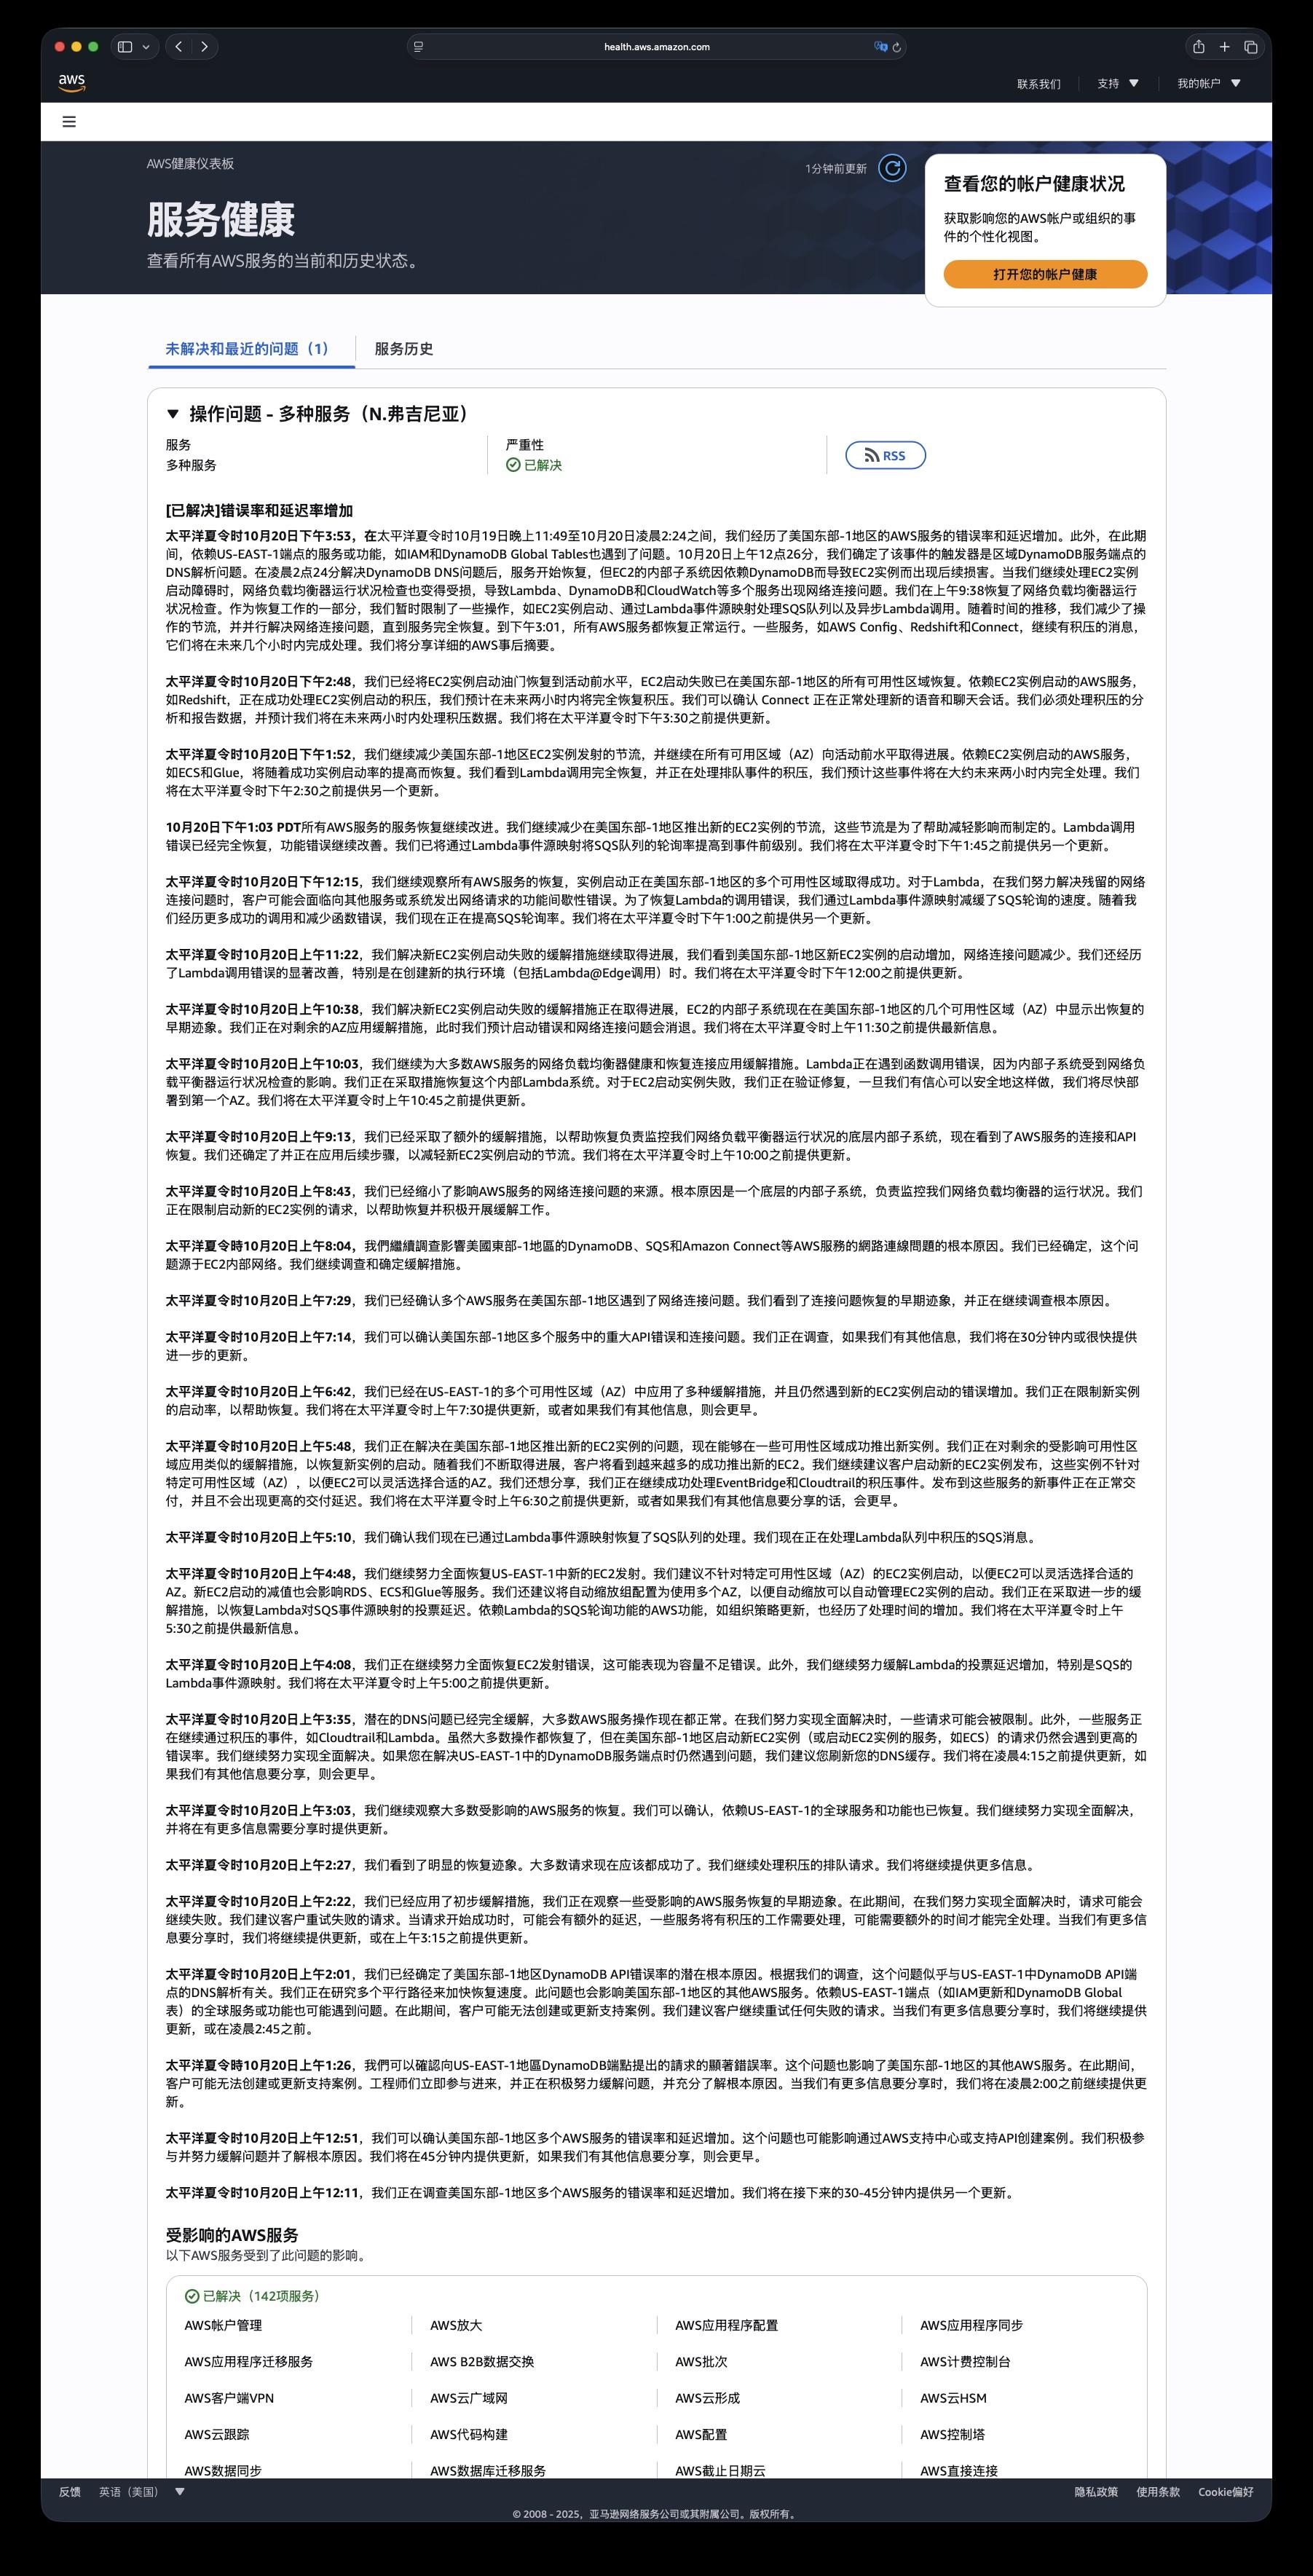
根据 AWS 发布的故障公告,根因看似简单:AWS 内部系统的一条 DNS 解析失败。但这个 “小故障” 却触发了惊人的级联效应。 DynamoDB 无法访问,而它恰恰是 AWS 控制平面的基石 —— IAM、EC2、Lambda、CloudWatch 等关键服务全部依赖它。
AWS 花了三个半小时修复 DNS,以为万事大吉,却没想到积压的请求产生了 “重试风暴”,再次压垮了 DynamoDB。 EC2、负载均衡器、Lambda 与 DynamoDB 之间的循环依赖让系统陷入死局。 AWS 被迫采用手工限流的方式,通过限制启动 EC2 实例,限流 Lambda/SQS 轮询来缓解压力,直到下午才逐渐恢复。
级联放大:互联网的阿喀琉斯之踵
us-east-1 不是普通的数据中心,它是 AWS 全球基础设施的中枢神经系统。 除了独立运营的国区、美国政务云和欧盟主权云,其他所有 AWS 区域的全局性控制平面都在这个区域里。
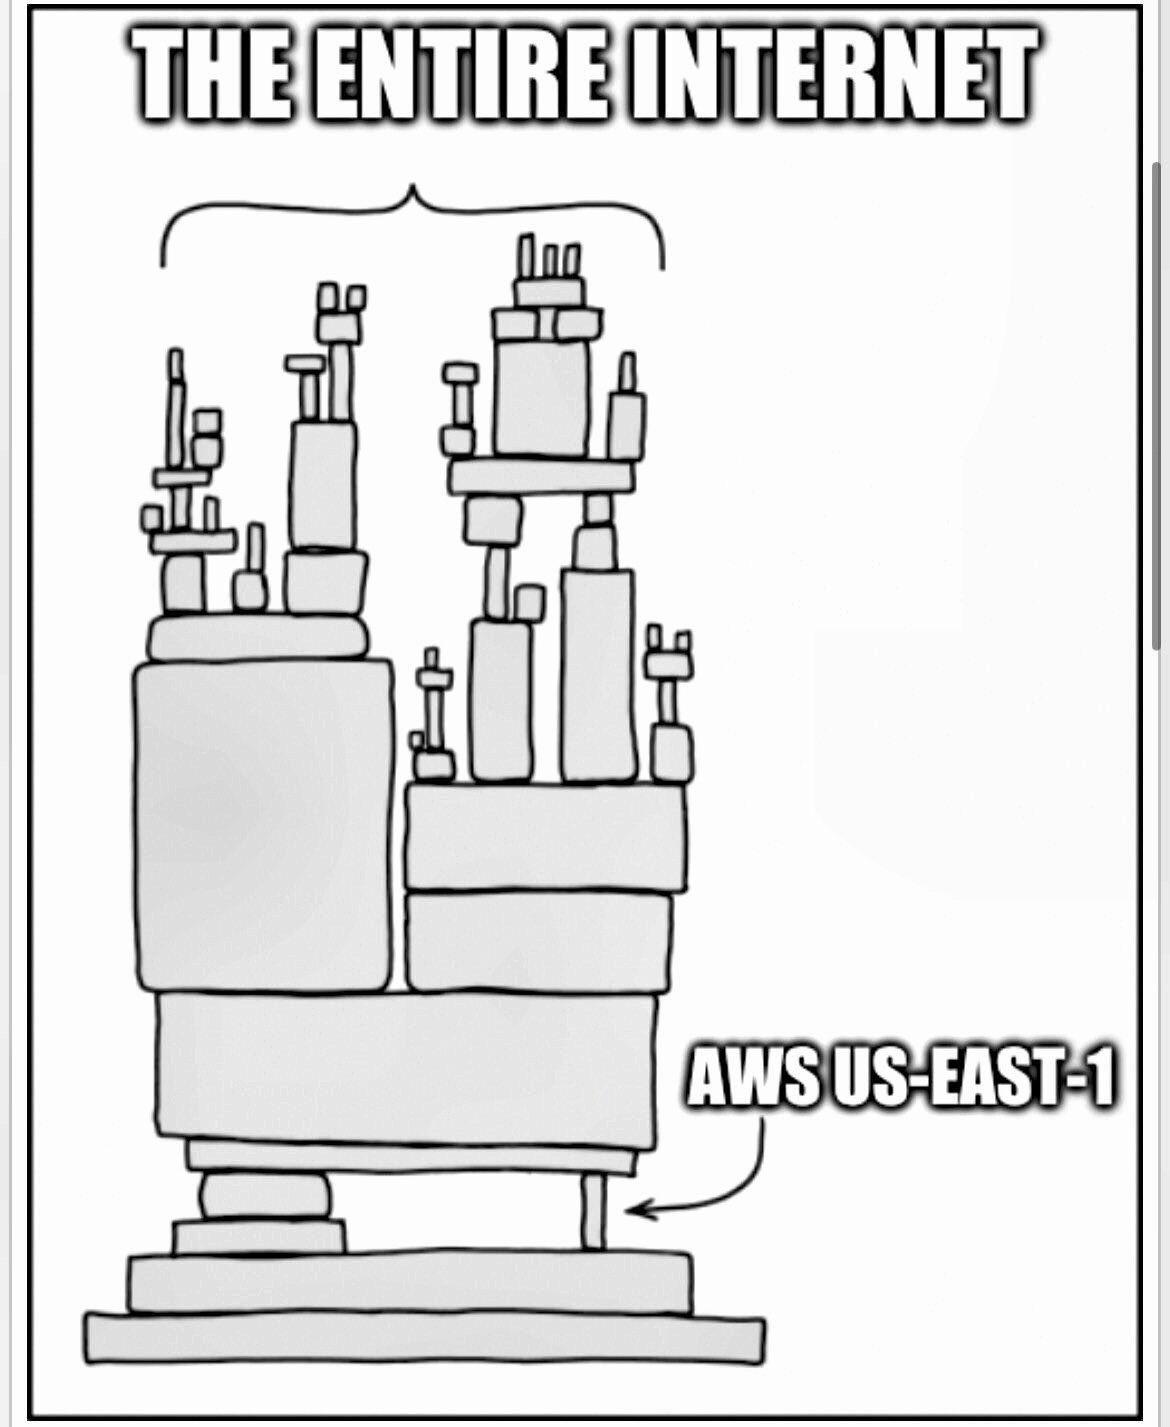
这意味着什么?即使你的应用部署在东京或法兰克福,当需要进行 IAM 认证、配置 S3、访问 DynamoDB 全局表、调用 Route 53 时,请求仍要路由到 us-east-1。 这次故障中,英国政府网站、Lloyds 银行、加拿大 Wealthsimple —— 这些看似与美东无关的服务,都因这种隐性依赖而瘫痪。
us-east-1 的特殊地位源于历史 —— 作为 AWS 的第一个区域,19 年的演进让它积累了大量技术债务。 重构它?数百万行代码、数千个微服务、难以计数的客户依赖,任何改动都可能引发更大灾难。 于是 AWS 选择了维持现状,直到故障再次提醒我们这个选择的代价。
技术解剖:小故障如何演变为大灾难
从 2017 年到 2025 年,us-east-1 的每次重大故障都暴露了相同的架构反模式,而 AWS 似乎从未真正吸取教训。
| 维度 | 2017 S3 故障 | 2020 Kinesis 故障 | 2025 DNS 故障 |
|---|---|---|---|
| 触发因素 | 人为错误 (胖手指) | 扩容 (线程限制) | DNS 解析失败 (原因未披露) |
| 核心服务 | S3 | Kinesis | DynamoDB |
| 持续时间 | ~4 小时 | 17 小时 | 16 小时 |
| 级联机制 | S3 → EC2 → EBS → Lambda | Kinesis → EventBridge → ECS/EKS → CloudWatch→Cognito | DNS → DynamoDB → IAM → EC2 → NLB → Lambda / CloudWatch |
| 恢复挑战 | 大规模子系统重启 | 渐进式服务器重启,路由映射重建 | 重试风暴,积压处理,NLB 健康检查恢复 |
| 监控失明 | Service Health Dashboard 宕机 | CloudWatch 降级 | CloudWatch 和 服务健康看板受影响 |
| 全局影响 | US-EAST-1, 但影响依赖服务 | US-EAST-1 区域 | 全球 (IAM、全局表依赖) |
| 经济影响 | $1.5 亿 (S&P 500 公司) | 未公开估计 | 数十亿~数千亿美元 |
循环依赖的死亡螺旋
AWS 各项基础服务深度耦合,各项基础服务(IAM,EC2 管理,ELB)依赖 DynamoDB,DynamoDB 又依赖这些服务 —— 这种循环依赖会导致架构复杂度指数增长, 系统复杂度被隐藏在微服务的层层抽象之下,极大拉高故障分析定位,处理解决的难度与时长。平时岁月静好,故障时却成为死亡陷阱。 我们已经在 阿里云 ,OpenAI,滴滴 这些公司的翻车案例中见过太多类似的例子了。
中心化的单点故障
在 2020 年 Kinesis 故障后,AWS 大力推广蜂窝架构(Cell-Based),并公开称将自己的服务迁往这种新 Cell 架构。 但从目前来看,us-east-1 区域依然是整个 AWS 全球全局控制平面的单点,牵一发而动全身,故障爆炸半径巨大。 尽管 AWS 声称在 us-east-1 部署了六个可用区提供冗余,但遇到 DNS 这种全局基础服务故障时,依然形同虚设。 这揭示了一个残酷真相:再精妙的多区域设计,也敌不过一个单点依赖。
监控系统的自我失明
最荒谬的是,AWS 自己的监控工具也依赖被监控的服务。当故障发生时,监控系统也随之失明。这创造了一个悖论:最需要监控数据的时候,恰恰是监控系统最不可用的时候。 外部监控平台如 Datadog 同样托管在 AWS 上,形成了 “自己监控自己” 的闭环。 故障发生 75 分钟后,AWS 状态页面仍然是 “万里江山一片绿” —— 也许不是他们在撒谎,而是监控系统自己也瘫痪了。
断路器的集体缺席
尽管 AWS 发布了大量关于实施断路器的最佳实践指南,但这次故障显示出,AWS 自己的内部服务网格可能并没有实施这些机制。 断路器本应在检测到下游服务故障时自动 “熔断”,停止发送请求,避免雪崩。但实际情况是,当 DynamoDB 出现问题,所有依赖服务继续疯狂重试,形成 “重试风暴”。 AWS 最终被迫手动介入,通过人工限流来控制局面 —— 这种原始的应对方式,与其宣扬的 “自动化一切” 理念形成鲜明对比。
知识流失:组织功能障碍的技术表现
在运维圈里有句名言 —— “_It’s always DNS_” 。任何经验丰富的 SRE 遇到这种事都会优先检查 DNS。 但 AWS 团队却在黑暗中摸索了两个多小时,然后又在断路限流的路上挣扎了五个小时。精锐尽失的团队难堪大任,这无疑是草台班子理论的又一例证。
2022-2025 年间,亚马逊裁员超过 27000 人。内部文件显示,各个级别 “不希望流失的人才” (Regretted Attrition)的流失率高达 69-81%。 强制返回办公室政策进一步推动高级人才离职。Justin Garrison 在 2023 年离职时就预言会有更多大规模故障 —— 事实证明他还是太乐观。
Regretted Attrition:即企业本不希望他们离职、但他们仍主动离开的员工。 即在所有离职员工中,有 69–81% 属于公司不希望失去的人。
组织记忆的流失是不可逆的。那些知道系统隐秘依赖关系的老工程师走了,留下的新人即使再努力,也缺乏诊断复杂级联故障的直觉。 这种隐性知识无法通过文档传承,只能通过多年的事故响应经验积累。当下一个 “边缘案例” 出现时,缺乏经验的团队只能眼睁睁看着系统崩溃,并花费老司机几十上百倍的时间去摸索定位与笨拙处理。
云经济学家 Corey Quinn 在《亚马逊人才流失终于导致 AWS 走向衰落》中辛辣评论道: “当你炒掉最优秀的工程师时,就别惊讶云厂商会忘记 DNS 是怎么工作的” —— “下一次大故障已经在酝酿中,只是哪个人手不足的团队率先被哪个边缘案例绊倒的问题而已。”
冷峻未来:应对云计算带来的脆弱性
在几个月前,Google IAM 故障带崩半个互联网;仅半年不到,AWS DNS 故障再次把全球互联网拉下水。 当一家云厂商内部的一条 DNS 记录损坏,就能让全球数千万用户的生活陷入混乱;当一个区域的数据中心网络故障,能让遍布五大洲的企业同时瘫痪, 我们必须承认:云计算在带来便利的同时,也创造了前所未有的系统性脆弱性。
更何况,当三家美国公司控制全球 63% 的云基础设施,这已经不仅是技术问题,更是地缘政治风险和数字主权挑战。单一供应商的便利性与全球性的脆弱性构成了一个危险的悖论。
在云服务商的营销话术中,“99.99% 可用性”、“全球多活冗余”、“企业级可靠性” 是标配承诺。 但将 AWS、Azure、Google Cloud 近年的实际故障记录摆在一起,云可靠性的神话开始动摇。 Cherry Servers 在 2025 年发布的研究 揭示了残酷的数据: 过去一年 AWS 发生了 38 次故障,平均恢复时间 1.5 小时;Google Cloud 发生了 78 次,平均 5.8 小时;Azure 虽仅 9 次,但平均时长高达 14.6 小时
| Cloud Provider | Incidents (2024.08 – 2025.08) | Average Duration |
|---|---|---|
| AWS | 38 | 1.5 hours |
| Google Cloud | 78 | 5.8 hours |
| Microsoft Azure | 9 | 14.6 hours |
Headline Numbers: Incidents Summary
“下云” 正从异端想法变成现实选项。在此次 AWS 宕机中,马斯克旗下的社交平台 X(原推特)因独立运营而安然无恙。老马在 X 对 AWS 发出多次嘲讽与揶揄。 知名 SaaS 厂商 37signals 则早在 2022 年就决定将 Basecamp 和 HEY 邮件服务迁出公有云,预计五年内节省约超过千万万美元云开支。 Dropbox 更是在 2016 年便开始逐步减少对 AWS 的依赖,重返自建数据中心。这并不是技术倒退,而是对过度集中化风险的理性校正。
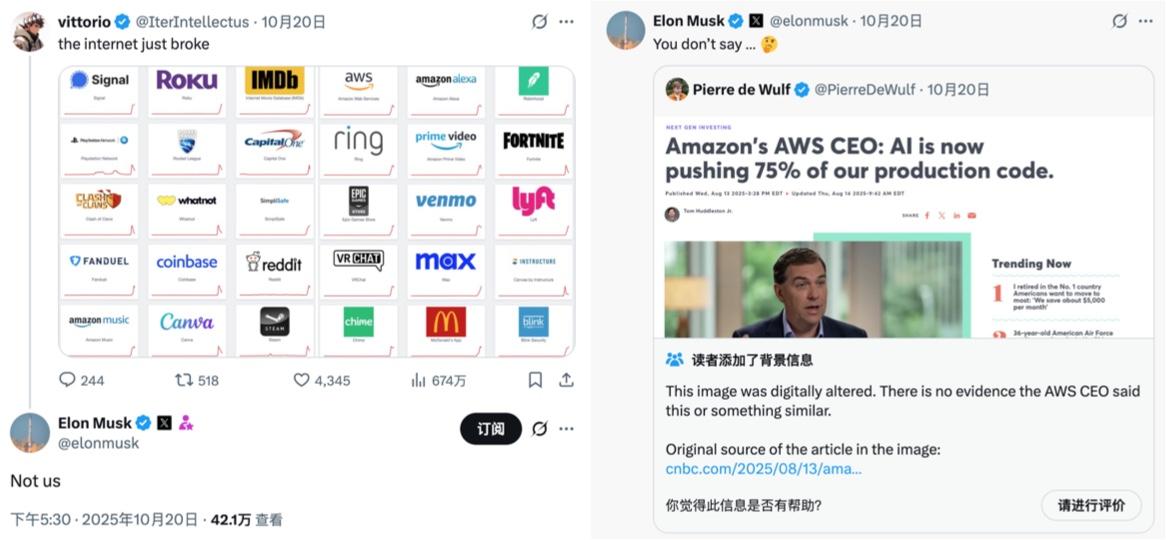
对于有能力的企业来说,混合部署——将核心系统自主可控部署,本地掌握底线,而将弹性扩展需求交给云端处理,可能是更明智的选择。 每一家依赖云的公司都需要认真思考:是否所有工作负载都必须上云?那些关键系统是否应该保留独立运行的能力,以在云崩溃时维持最基本的服务?
在脆弱性中构建韧性,在依赖与集中化中保持独立自主 —— 这不是技术选择,而是生存哲学。 us-east-1 还会再次故障 —— 不是是否,而是何时。所以真正的问题是:下一次故障发生时,你是否已经准备好了?
参考阅读
AWS: Update - AWS services operating normally
AWS: Service Health, Operational issue - Multiple services (N. Virginia)
HackerNews: AWS multiple services outage in us-east-1
CNN: Amazon says systems are back online after global internet outage
Register: Today is when the Amazon brain drain finally sent AWS down the spout
Converge: DNS Failure Triggers Multi-Service AWS Disruption in US-EAST-1
云故障
- AWS 最大区域故障,带崩多项服务
- 知乎挂了:证书问题还是 CDN 翻车?
- 阿里云故障,CDN 挂了,记得申请 SLA 赔付
- Apple,Google,FB,TG 160 亿登录信息泄露
- 带瘫全球互联网,Google 云 / Cloudflare 全球故障
- 大故障:阿里云核心域名被拖走了
- 深度分析:迪奥数据泄露事件,云配置失当的锅?
- 10 万用户的软件,因腾讯云欠费 2 元灰飞烟灭?
- AWS 东京可用区故障:影响 13 项服务
- Shopify:愚人节真的翻车了
- Oracle 云大翻车:6 百万用户认证数据泄漏
- OpenAI 全球宕机复盘:K8S 循环依赖
- 支付宝崩了?双十一整活王又来了
- 草台回旋镖:Apple Music 证书过期服务中断
- 阿里云:高可用容灾神话的破灭
- 阿里云故障预报:本次事故将持续至 20 年后?
- 阿里云盘灾难级 BUG:能看别人照片?
- 阿里云新加坡可用区 C 故障,网传机房着火
- 这次轮到 WPS 崩了
- 草台班子唱大戏,阿里云 RDS 翻车记
- 我们能从网易云音乐故障中学到什么?
- GitHub 全站故障,又是数据库上翻的车?
- 全球 Windows 蓝屏:甲乙双方都是草台班子
- 阿里云又挂了,这次是光缆被挖断了?
- 删库:Google 云爆破了大基金的整个云账户
- 云上黑暗森林:打爆云账单,只需要 S3 桶名
- taobao.com 证书过期
- 我们能从腾讯云故障复盘中学到什么?
- 云 SLA 是安慰剂还是厕纸合同?
- 腾讯云:颜面尽失的草台班子
- 【腾讯】云计算史诗级二翻车来了
- 互联网故障背后的草台班子们 马工
- 从降本增笑到真的降本增效
- 阿里云周爆:云数据库管控又挂了
- 我们能从阿里云史诗级故障中学到什么
- 【阿里】云计算史诗级大翻车来了
云资源
- 花钱买罪受的大冤种:逃离云计算妙瓦底
- 云数据库是不是智商税
- 云盘是不是杀猪盘?
- 剖析云上算力真实成本
- 扒皮对象存储:从降本到杀猪
- 垃圾腾讯云 CDN:从入门到放弃
- 记一次阿里云 DCDN 加速仅 32 秒就欠了 1600 的问题处理 转
- 云 SLA 是安慰剂还是厕纸合同?
- FinOps 终点是下云
- 本土云计算为啥还没挖沙子赚钱?
- 云 SLA 是不是安慰剂?
- 范式转移:从云到本地优先
下云记